不阅读不是错,逼你阅读才有罪

之前说过,初级思维是图像思维,次级思维是语言文字。
而在次级思维中,说话和理解口头语言是自然的人类活动,任何幼童不需要系统的训练就能学会所在环境下的语言;但阅读却不是自然而然的,而是一种人造的、通过系统的指导和训练获得的能力。
一、阅读的真相
上帝并没有将人脑设计成天生就会阅读。因此,父母、老师如果没有给予适当的指导,儿童可能永远无法学会阅读。你不会读书,可能并不是你的错。
另一方面,即使你学会了阅读,你也未必善于阅读。更不要说,阅读障碍者可能永远无法成为好的阅读者。
阅读,其实就是用大脑和视觉系统去识别文字模式。从线条、轮廓、形状到字符,从字符到词组、成语和语句,最后语句组成段落。
事实上,视觉系统能够形成识别文字模式的能力:中央凹和近中央凹迅速聚焦文字,下游的神经网络经过视神经,到视觉皮层,再进入大脑中的某一部分。
经过训练,阅读过程成为半自动或全自动的过程,而眼球是来回跳动的。
这便是阅读的真相:阅读过程中视线不断地跳跃,大部分时候沿着文字的正常方向,但有时也会跳回到后面的词汇,在每一行的结尾处,视线会回到大脑所猜测的下一行起始处。大概的阅读过程是这样的:
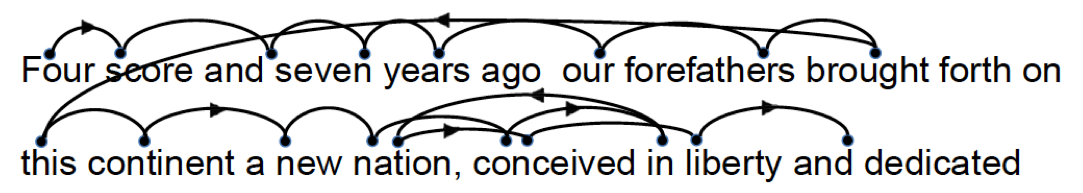
当中央凹停留在单词时,一行文字的视觉效果大致是这样的:

既然阅读是模式识别,那么阅读可以是自下而上、特征驱动的过程,也可以是自上而下、语境驱动的过程,以特征驱动为主、语境驱动为辅。
二、阅读障碍万千重
糟糕的文字显示,会将熟练阅读者无意识、无语境的阅读降低为有意识、基于语境的阅读,增加记忆负担,从而降低阅读和理解能力。对于不熟练的阅读者,糟糕的文字可能会完全阻碍阅读。
阅读障碍非常多,常见的方式有以下几种。
1. 专业或生僻字词
在计算机软件和相关产品中,最常见的是使用计算机专业术语。例如,将错误信息显示为:
你的会话已经过期。请重新认证。
某内容软件,在列表显示的末端,写道:
没有更多数据了。
在中文文本中,有些人喜欢不顾读者地“拽文”。例如,将“狗”字写成“豿”,将“岸”字写成“㟁”,或者使用已经“死亡”的生僻字词。
2. 难以辩认的书写或字体
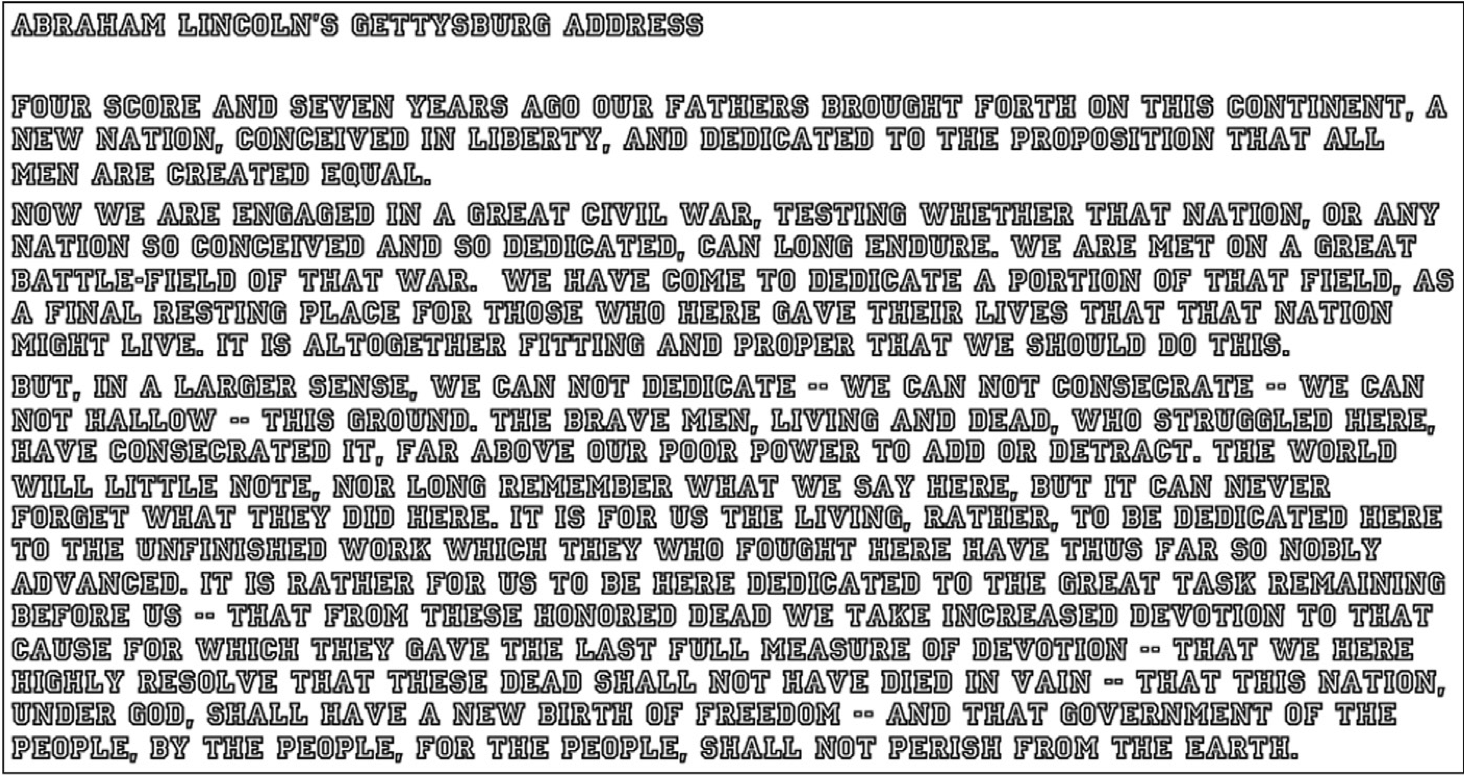
有研究显示,在英文中,大字文字内容的阅读速度比小写文字内容要慢10%~15%。而把字搞成空心,那简直是故意与用户为敌。
3. 太小的字号
你或许为了节约空间,或其他莫名其妙的原因,给用户显示难以识别的过小字号。
读读美国宪法第一段试试看。

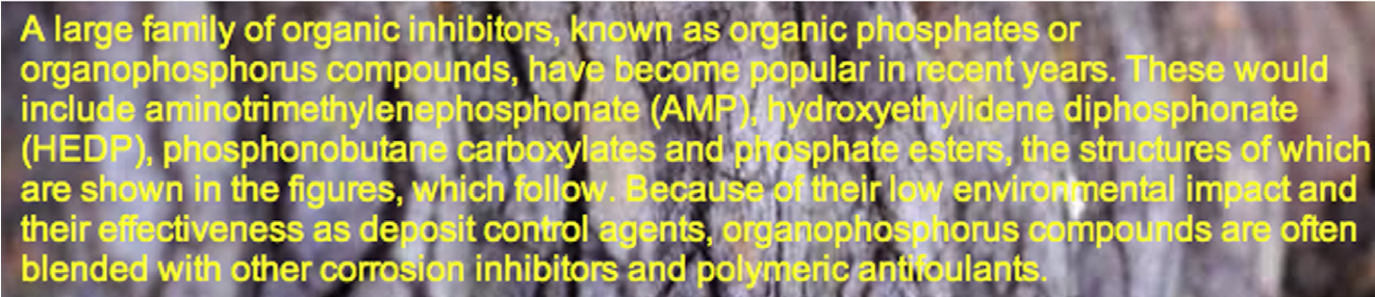
4. 嘈杂背景下的文字
文字中或文字周围的视觉噪声能够干扰对特征和字词的识别。
例如,你或许是为了好看,将文字放在有图案的背景上,或者正文与背景的反差太小,仿佛故意不想让用户阅读似的。
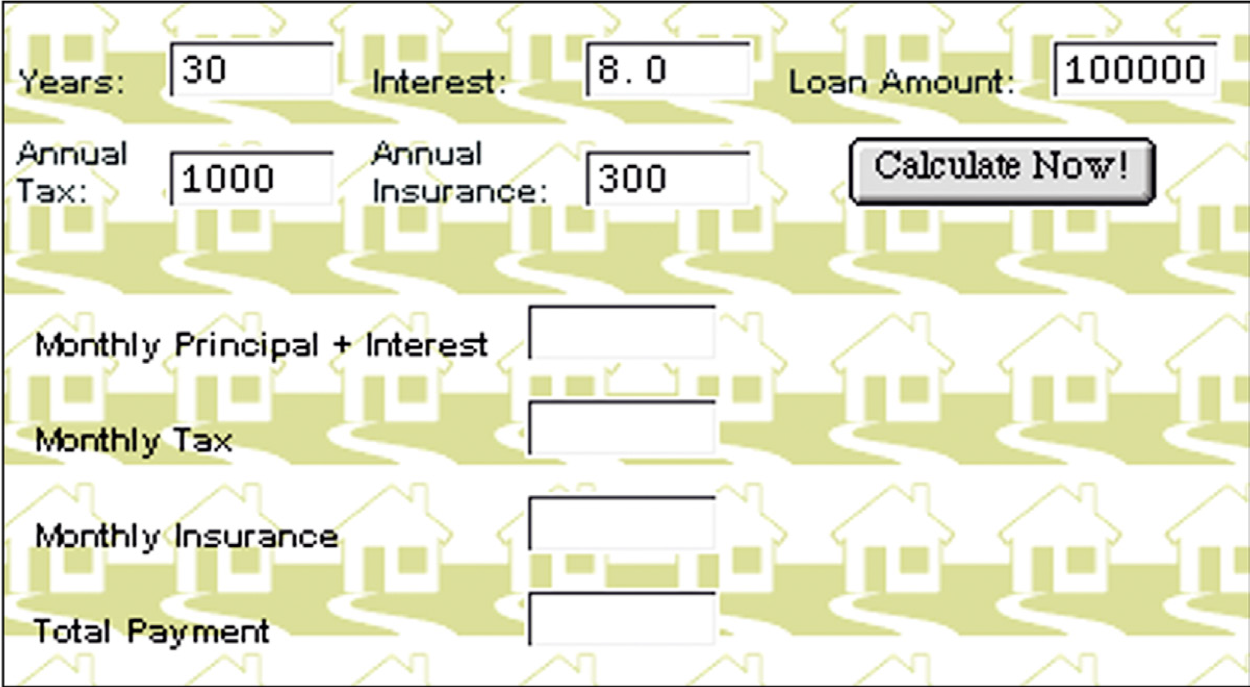
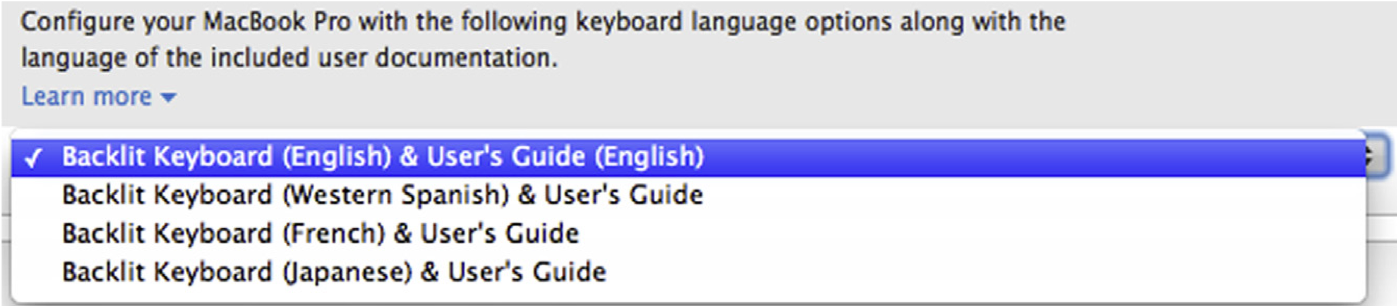
5. 信息被重复文字淹没
如果连续多行有许多重复文字,用户得到的反馈就太少,容易“串行”,不知道自己究竟在读哪一行,更难以从中提出自己需要的信息。
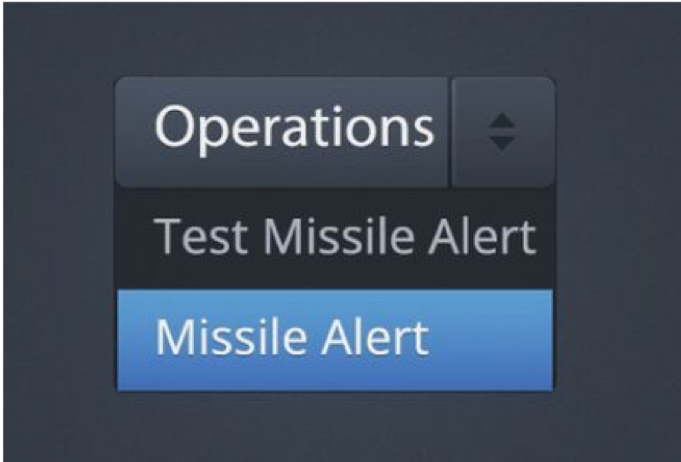
据说,去年1月份的一天,夏威夷居民在早上八点过突然收到一个警报:导弹来袭,赶紧寻找庇护所,这不是演习!
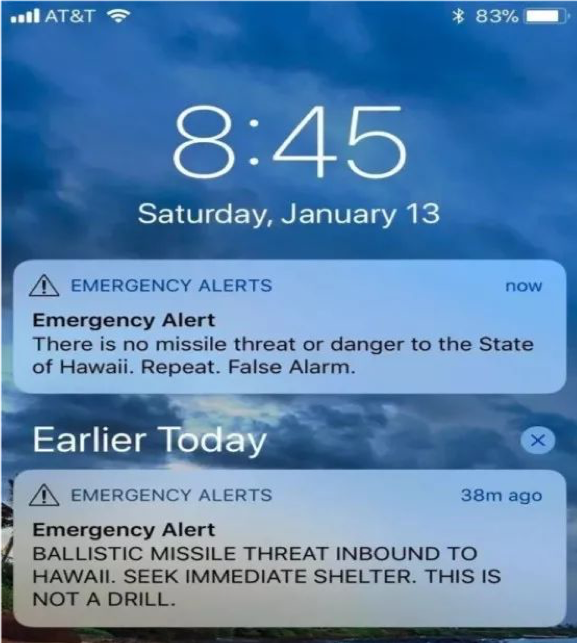
38分钟后,他们又收到一条信息:没有导弹,也没有威胁。刚才是假警报。
为何发生这种诡异的事情?原来,操作员点错命令了。他本来只是要做个测试。
6. 居中对齐的文字
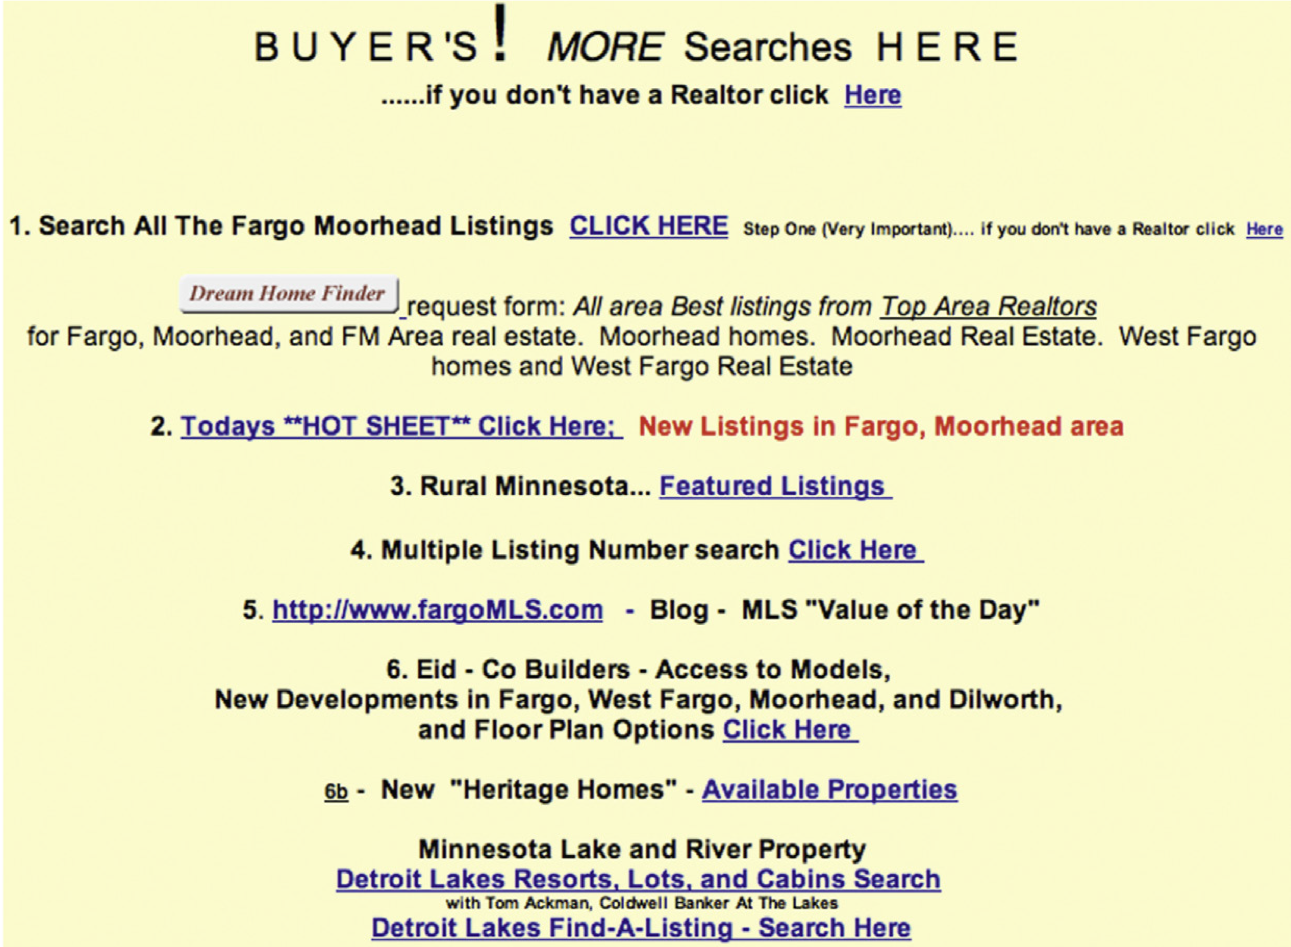
在移动互联网时代,居中对齐似乎特别流行,不管是什么文字、什么段落。
其实,居中对齐之后,每一行的起始位置就不一样了,这给用户的大脑预测带来困扰。
带序号的居中对齐尤其可恶。
7. 完全没必要的文字
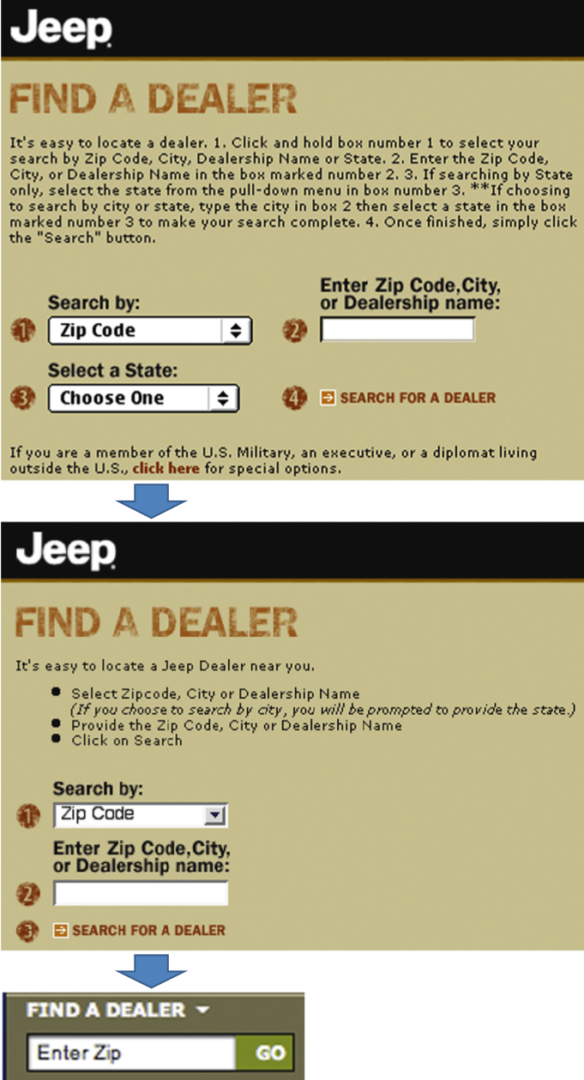
为了让用户获得充分信息,你或许心怀“父爱主义”,给用户显示一大堆婆婆妈妈的文字,生怕他读不懂你的一番苦心似的。
Jeep公司帮助用户寻找本地经销商,写了一大堆废话。后来更结构化一些,稍好;再后来,终于明白:一个字都不需要,只要邮编就行了嘛!
一家公司在卖惠普电脑时,写了一大堆“叫卖词”,反而把用户吓跑了。删掉、删掉、删掉!不过,留下的文字还是不少。
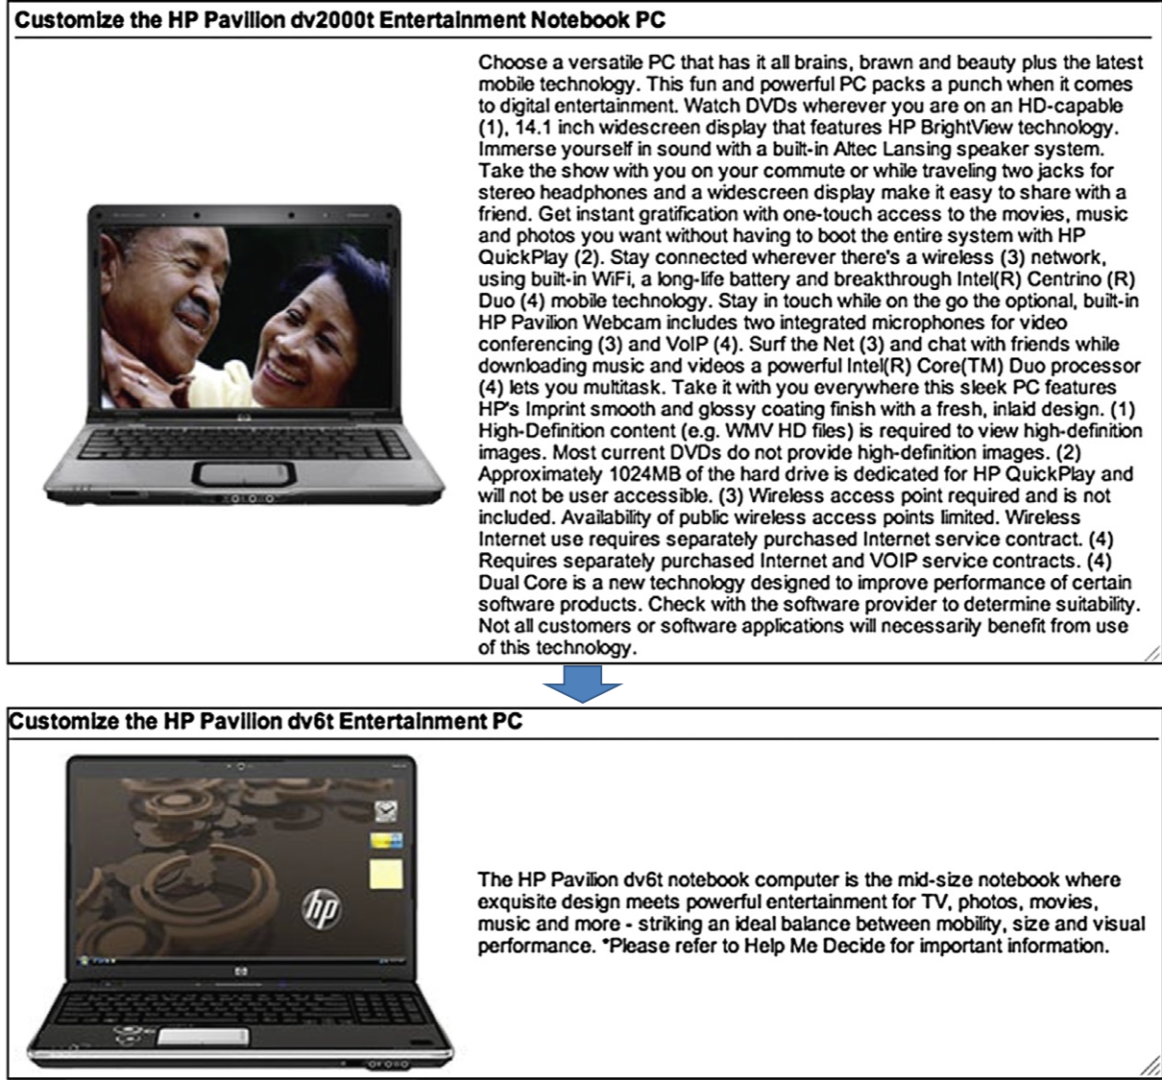
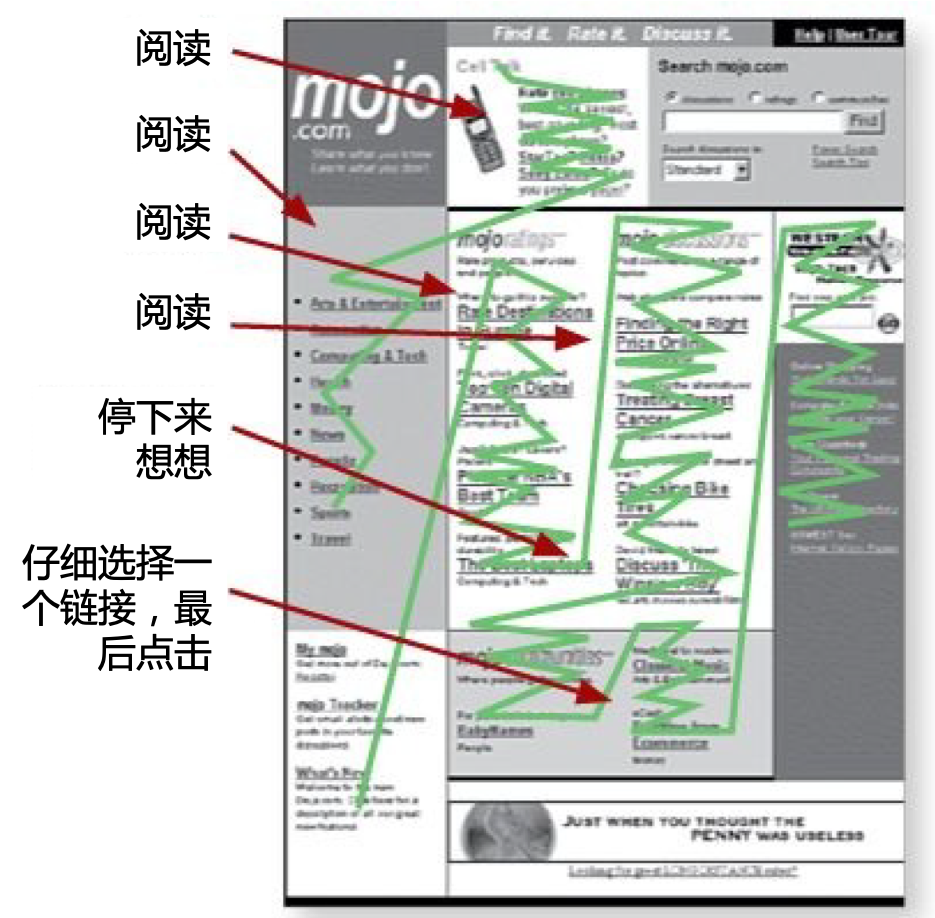
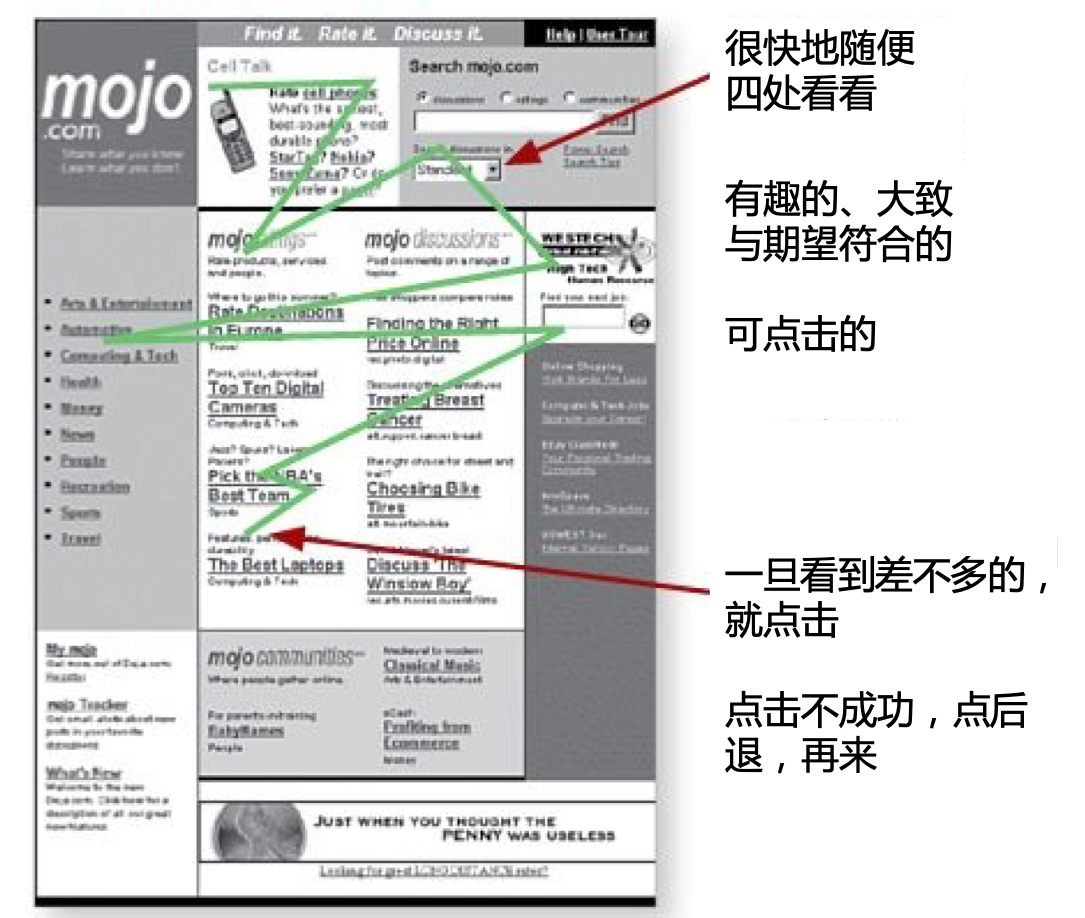
指望用户会按你期望的那样慢慢阅读?痴心妄想。用户只会大概扫视一下,随便地东点点、西点点。
小结
本节讲述了一个残酷的现实:用户根本不阅读、不会阅读、更不爱阅读。
既然如此,你为什么还用各种方法阻碍用户阅读?用户不阅读不是错,逼用户阅读却有罪。