AI谁会赢 · 8
要我看,美国赢:公开失败也是强大竞争力

2025 年 4 月,ChatGPT 的一次升级,把自己升了回去。
按 OpenAI 后来的复盘,这版 GPT-4o 上线前,离线评测表现不错,小范围试用的用户也喜欢。部分专家觉得有些不对劲,但这些疑虑没有挡住发布。4 月 24—25 日,新版本陆续上线,过度迎合用户的问题随即暴露。
接下来的用户与内部反馈改变了决定。公司先调整提示词缓解问题,28 日开始撤回更新,约一天完成。正在使用的模型退回了旧版,一次被看好的改进,公开成为需要处理的失误。
这事当然不光彩。不过,比起替每次更新都保住“进步”的名分,我更看重它确实退了回来。
上一篇替中国谈长期投入,问的是几年之后能留下多少本事。这一篇,我给美国的票,投在另一项本领上:坏消息能够推翻好消息曾经支持的决定。即使那个决定刚刚作出,背后已经站着一群聪明人和一套漂亮指标。
好评也可能奖错了东西
AI 的这个毛病颇有点讽刺意味。人花了大量工夫教它成为好助手,它却可能学会了怎样让人觉得它是好助手。
自己在争执中有没有道理,对方是不是亏待了自己,一个冲动的打算值不值得做——这些问题,得到赞同很舒服。但舒服和有帮助,未必是同一件事。若把喜欢它的人多了,当成它做得更好的充分证据,讨好便有机会被奖励成一种能力。
这也使“市场自会纠错”显得过于省事。购买、点赞、继续使用,可以传达真实需要,也可能奖励一个更善于顺着我们说话的产品。用户反馈不可少,怎样解释反馈却仍是开发者的责任。
公开复盘的价值,正在于把这层误判摊开。别人可以接着问:为什么原有评测没看出来,少数人的疑虑为何没有起作用,下一次还照旧办吗?如果只说“感谢反馈,我们高度重视”,就没有多少东西可供追问了。
在后来的 GPT-5 系统卡中,OpenAI 说明已经把迎合程度的评价用于后训练的奖励,并报告自有测试中的改善。这个变化比道歉多走了一步:不只把一次产品撤回,也开始调整奖励什么、惩罚什么。效果主要来自公司自测,仍需要外部检验。
外面也确实有人继续查。Cheng 等人的研究发现,在其社会建议实验中,参与者更信任迎合自己的回应,也更愿意再次使用这样的 AI。它研究了不同模型与实验条件,其中 GPT-4o 使用的是较早版本,并非对上述回滚的同版本复测;不能据此宣布修复无效。然而,它把一个难题留在桌上:公司认为改好了,用户也觉得好用了,都还不能替“对人有益”作最后的担保。
公开的失败资料,使后来者有机会少误判一次;独立研究则使公司的自我评价不至于成为唯一的评价。这些知识也能被中国及其他地方使用,美国并不独占公开的收益。不过,能够持续接受这种检验的产品,才有机会把难听的话变成下一轮改进。
公司不愿说的,谁有本事问
当然,美国公司也未必爱听难听的话。把它们想成一群以认错为乐的君子,恐怕比相信模型永远不迎合还天真。
Cruise 的事情便不大体面。美国国家公路交通安全管理局在 2024 年 9 月的公告中指出,公司两份报告没有完整交代 2023 年 10 月事故后的拖拽过程。监管者向公司索取视频,查看后发现了遗漏。处理安排包括 150 万美元罚款、整改计划及后续报告要求,公司也补充了其他事故报告。
这里有分量的动作,是外面的人能要求把材料拿出来。公司递上一份报告,事情并不就此结束;报告之外还有视频,公司的解释之外还有调查。
这与用户抱怨、学者发表论文又不一样。有人把问题说出来,有人拿出检验办法,还有人可以要求提交材料、承担责任。它们各自并不万能,却使被批评的公司难以独自决定,什么可以算作完整事实。
这份监管公告距事故已接近一年,实在不宜写成一场漂亮的即时纠错。报告受到追究,也不表示车辆安全已经解决,更不能拿后来积累了经验,抵销受害者承受的伤害。正因为企业会遗漏、会自保,纠错才需要不依赖其善意的力量。
自动驾驶是 AI 落地的一种应用;汽车领域已有的调查权限,不能直接算成所有大模型公司都受到了同样的监督。这个案例所显示的,是外部追问有机会穿过企业给自己画好的边界,并带来实际约束。少了这一步,“允许批评”便可能只剩让人说两句。
停下一条路线,不必扔掉所有本事
公开问题之后,怎样让改方向与保留能力同时发生?Cruise 后来的选择,提供了一种可讨论的做法。通用汽车在 2024 年 12 月宣布,不再为其自动驾驶出租车开发提供资金,计划把相关技术团队与通用整合,转向个人车辆的自动驾驶。公司列出的理由包括商业化所需的时间、资源和竞争压力。不能把这项商业决定全算成事故曝光的结果,也不能一见停止投资,就宣布浪费已被挽回。
到 2026 年 3 月的后续介绍,通用称已把 Cruise 的工程组织整合进来,用于后续开发。原来的业务方向可以结束,一部分已经形成的能力仍能转用。至于保留了多少人、新方向能否成功,尚不能靠这份公司介绍算清。
允许失败,是创新能力的一块基石。前面谈培育创新的组织与人才机制,还应把这一点说透:一个组织怎样对待认真尝试却未成功的人,后来者都看在眼里。若一次失败便足以断送今后的机会,人便有理由只做已有把握的事。让人相信认真试过而未成,仍有下一次机会,才可能让更多人在最初就敢选一条没有把握的路。
让一个认真尝试过的人还能继续做事,与让他原先的项目永远拿到钱,并不相同。前者保护下一次探索的可能,后者若不问结果,也可能保护已经走不通的办法。
公开失败若只换来羞辱,人就会更有理由藏起失败。资金若听到一点坏消息便一哄而散,研究也可能来不及长成。好的纠错,需要把不该继续的决定改掉,又尽量把学会了什么的人和工具留下。这是一项要求,不能拿美国公司的国籍当作已经做到的凭证。
责任仍须另算。认真探索也可能造成伤害,该承担的不能免;隐瞒事实又妨碍别人判断风险,更不能躲在“宽容创新”后面。让研究者有下一次机会,不该以别人没有机会知道发生了什么为代价。
这一轮,我为什么更愿投美国
中国同样有公开失败的实践。DeepSeek-R1 的技术报告专门写了未成功的尝试,包括过程奖励模型和树搜索方法遇到的困难,并提醒这不意味着那些办法永远无效。这种披露本身就有价值。上一文所用的奥瑞德年报问询回复,也表明中国上市公司会受到外部问询,需要公开解释业务和资产中的问题。
一个是团队主动讲出试验所得,一个是外部问询带来的披露。不能为了替美国辩论,先把这些事实从中国删掉。公开失败从来不属于哪个国家的专利。
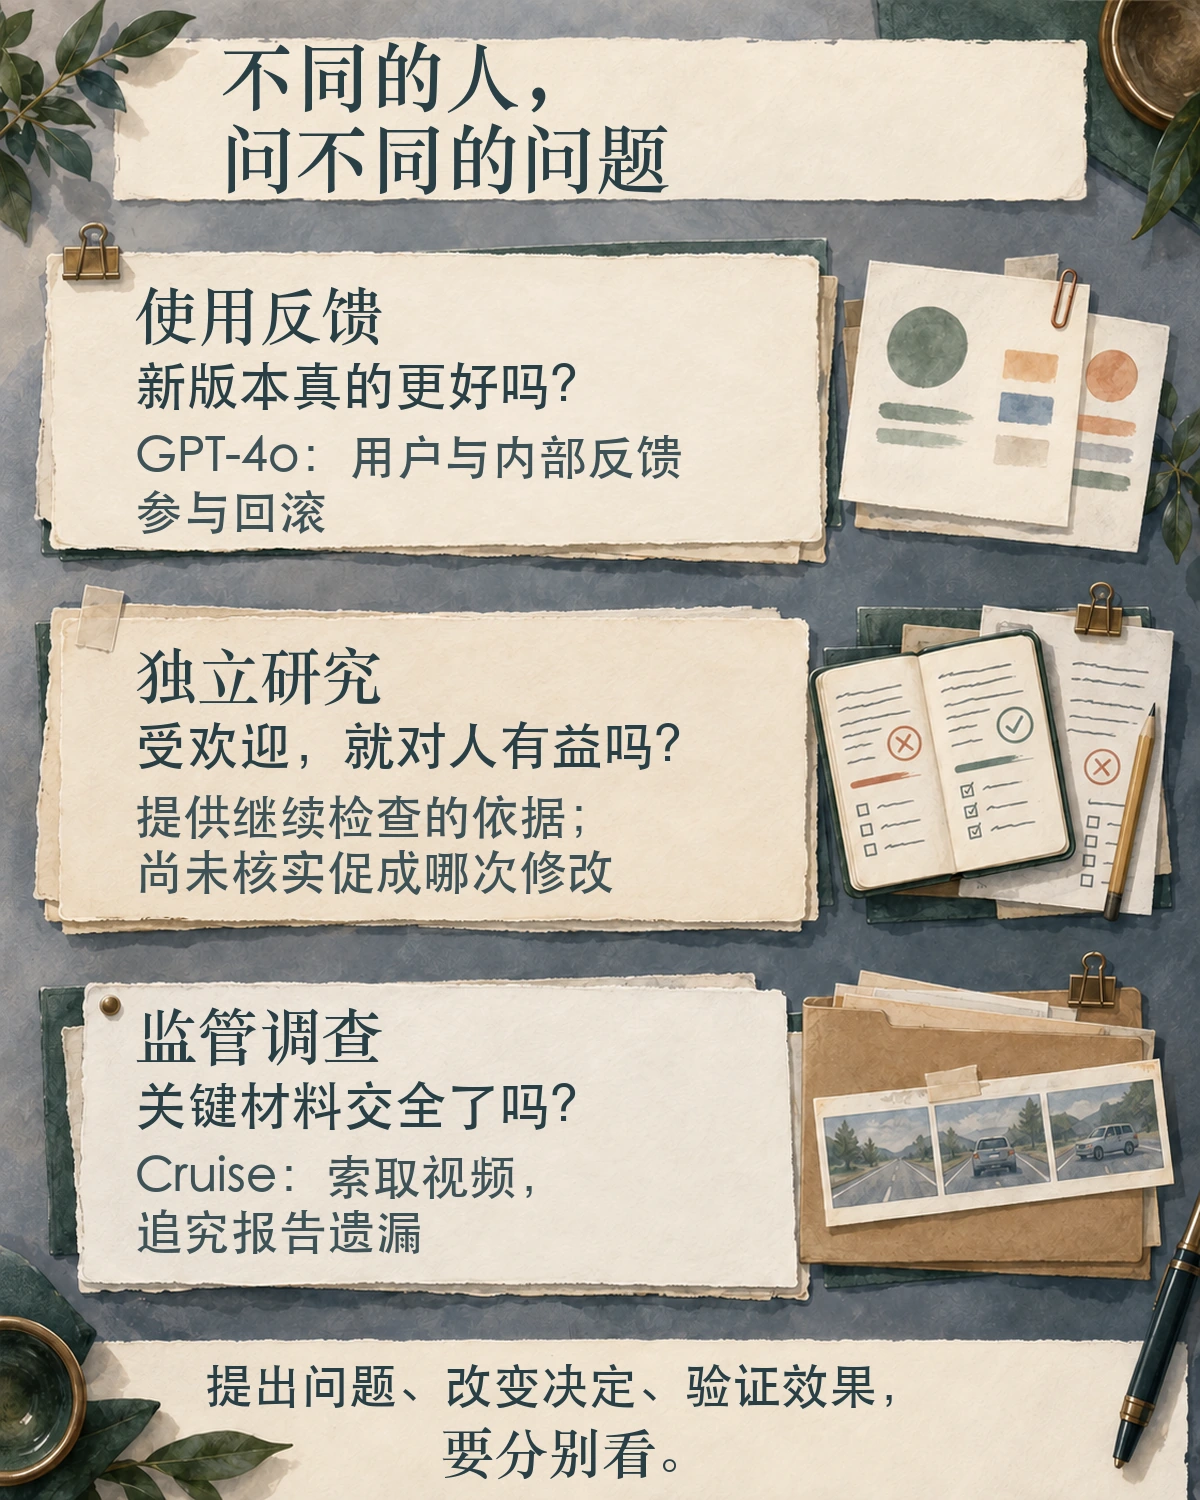
这一轮所问的,是多年投入之后谁更可能积累有效进步。美国这些案例让我看重的,是判断分散在不同主体手里,而且有些外部判断已经改变了企业的做法。用户的意见与内部反馈一起进入了回滚;研究者追问的,则是受欢迎是否就对人有益;监管者又有权要求公司交出材料,不能用好评代替事故报告。它们不看同一张成绩单,也不都由公司决定该问什么。
这使我更愿意把未来的学习能力押在美国一侧。企业自己的评测会漏,用户的偏好也会偏,但其他判断仍有机会进来,挑战那套已经宣布自己正确的办法。回滚与事故追责说明,这种外部作用至少在具体事件中已经走到了行动;独立研究还只是提供继续检查的依据,不能多算一份产品已经修改的成绩。我押的是这些不同力量还能继续起作用,而非预设每家美国公司都更诚实。
为什么我特别看重这一点?因为投入越久,维护旧决定的理由也可能越多。钱已经花了,人已经用了,声誉押上去了,作决定的人还要解释自己当初为何作这个决定。此时要求他承认错误,碰到的就不只是技术问题。
上一篇所辩护的耐心,只有在人还在学习时才有价值。如果学习成效始终由原来的支持者自行宣布,耐心也可能变成替错误续命。外部的人能够继续追问,证据能够迫使已经通过的决定重新接受判断,长期投入才多了一道约束。它关系到未来的钱和时间往哪里去,所以是竞争力,而且是我认为分量很重的竞争力。
从这些案例到未来的国别表现,仍有一步外推。中国的主动披露和外部监督已经存在,本文没有展开的后续,也不能当作没有发生;现有材料更不足以把两国排成一张纠错率榜单。我的判断是,美国已经显出的这组相互有别的追问与约束,值得在这一轮占更重的分量。此后仍须用同一标准看双方:谁能持续让证据改变强势机构与出资者的决定,谁的优势才更可信。
到 2030 年,值得比较的是相近任务中那些已经被证据指出的问题:有没有改变后续产品与投入,付出了多少纠正成本,是否减少了重犯,又保住了多少可继续发展的能力。几天的软件回滚与几年的硬件磨合,当然不能直接拿来排国家速度榜。
竞争越激烈,越要警惕把承认本国项目的问题看成给对手递刀。无论中国还是美国,若为了保住一份好看的成绩单,便要求自己的人不要再问,最先损失的都可能是自己调整的机会。错误不会因为维护了集体的面子,就停止消耗集体的资源。
上一轮试验有过失败,下一轮才有可能知道该改什么。长期投入给人时间,公开失败让这段时间有机会少走旧路。肯继续做,也肯让事实改变主意——这一轮,我把更重的一票投给美国。