为什么计算机要区分好几种“空”
从 null、void 到 IT 背后的哲学

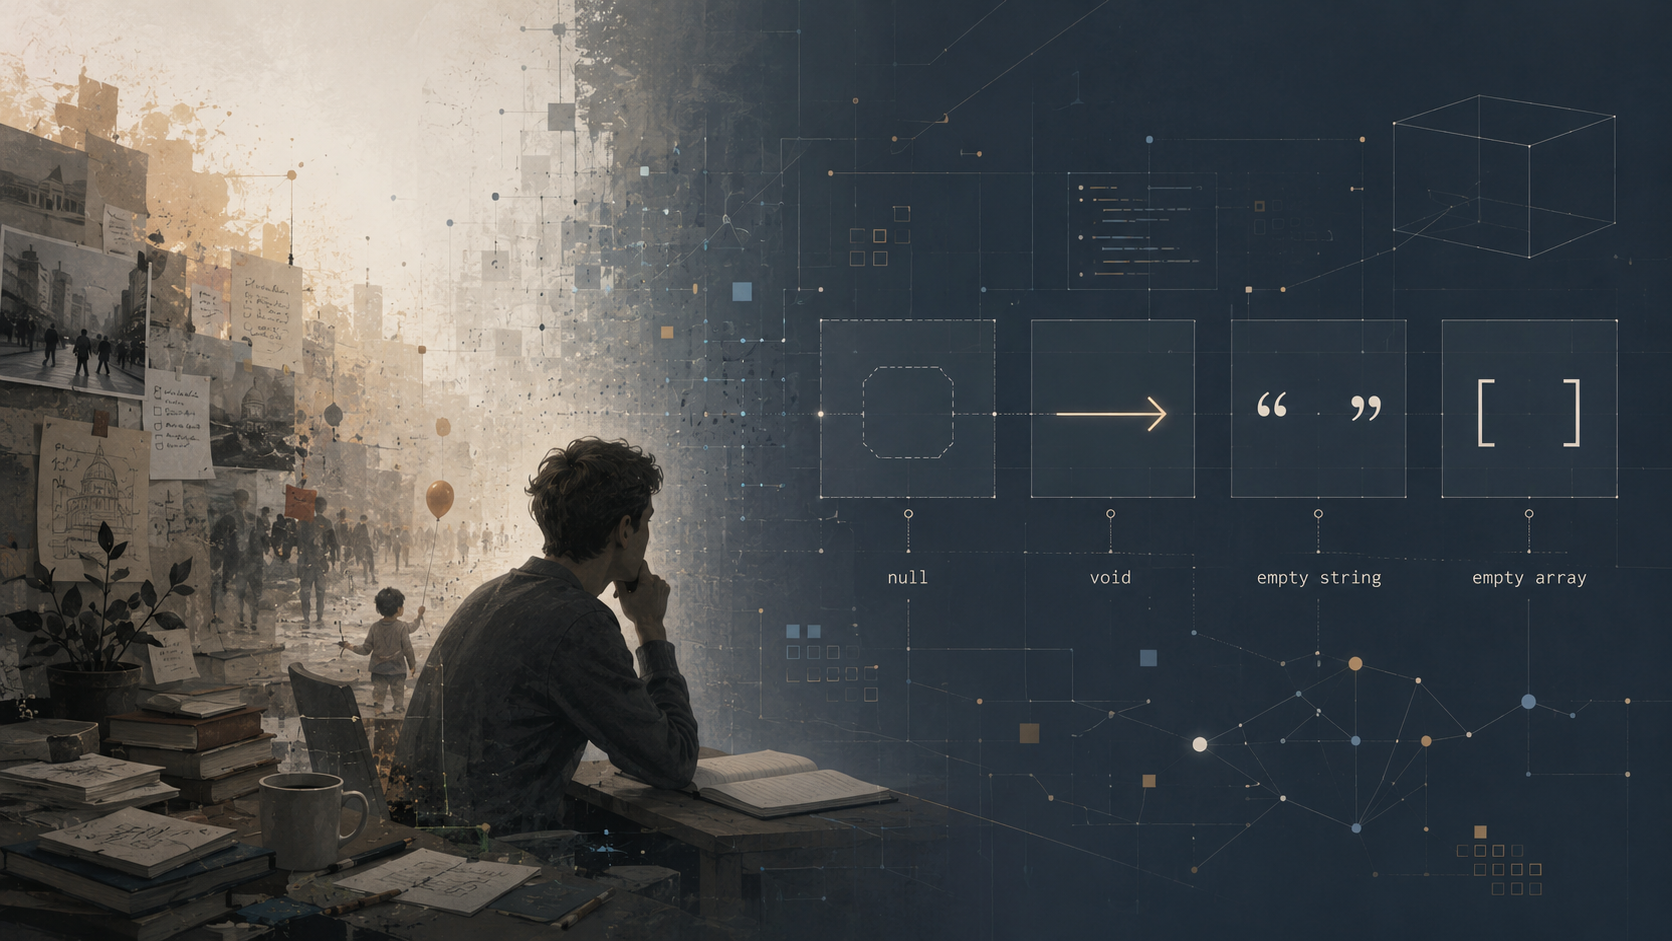
现实进入计算机之前,必须先被拆分、命名和重新定义。null、void、空字符串与空数组,代表的并不是同一种“空”。
有一天,我突然想到一个好玩的事:
如果一个 IT 人喜欢思考,他其实很容易成为一个哲学家。
我不是说程序员天生就爱谈逻辑,也不是因为代码看起来深奥,而是因为 IT 所做的事情,本身就带有一种哲学性质:
它必须重新定义世界最基本的概念。
什么叫存在?
什么叫空?
什么叫同一个人?
什么叫状态发生了改变?
什么叫一件事情已经发生,却没有产生返回结果?
这些问题若不先被回答,现实世界就无法进入计算机。
准确地说,IT 并不是简单地把现实搬进机器。现实太混乱、太连续,也太暧昧,无法被机器直接理解。IT 必须先把现实拆开、命名、分类、建立关系,再把它重建为一个可以运行的世界。
只有经过这场抽象,世界才能在 IT 中站立。
一、现实世界可以含糊,计算机世界不可以
人在日常生活中可以说:“这个地方是空的。”
但计算机马上会追问:究竟是哪一种空?
是这个位置本来就不应该有东西,还是应该有东西,却暂时没有?
是尚未赋值,还是已经清除?
是没有返回结果,还是返回了一个代表“空”的结果?
人可以把这些情况混在一起,机器却不能。
于是,编程语言不得不发明不同的“空”:
void,通常表示一个过程不返回值。null,表示这里有一个位置,但现在没有对象。undefined,常常表示某个值尚未被定义,或者根本没有出现。
空字符串 "" 则不是没有值,而是一个确实存在的字符串,只不过长度为零。
空数组也不是“什么都没有”。数组存在,只是其中暂时没有成员。
在人看来,它们似乎都是“空”;在计算机看来,却是几种完全不同的存在状态。
这已经不是普通的工程分类,而是一套微型存在论。
二、void 与 null:两种不同的“无”
void 和 null 看起来都像“没有”,但它们表达的并不是同一种没有。
一个函数返回 void,通常不是说它没有发生任何事情。相反,它可能已经写入文件、更新数据库、发送消息,或者改变了系统状态。它只是没有向调用者返回一个值。
因此,void 更接近:
事情已经发生,但没有可以带走的结果。
它不是存在的缺席,而是返回值的缺席。
null 则不同。null 通常意味着:这里原本允许指向某个对象,但现在没有指向任何对象。位置还在,结构还在,期待也还在,只是对象缺席了。
因此,null 更接近:
这里本应可以有某物,但此刻没有。
这也是为什么空指针错误如此危险。程序沿着一个引用去寻找对象,最后却发现,那个位置后面什么也没有。
系统不是因为“无”而崩溃,而是因为它把一种“无”误认为了“有”。
很多现实悲剧也是如此。真正危险的往往不是不知道,而是把缺席误认为存在,把愿望误认为事实,把名称误认为实体。
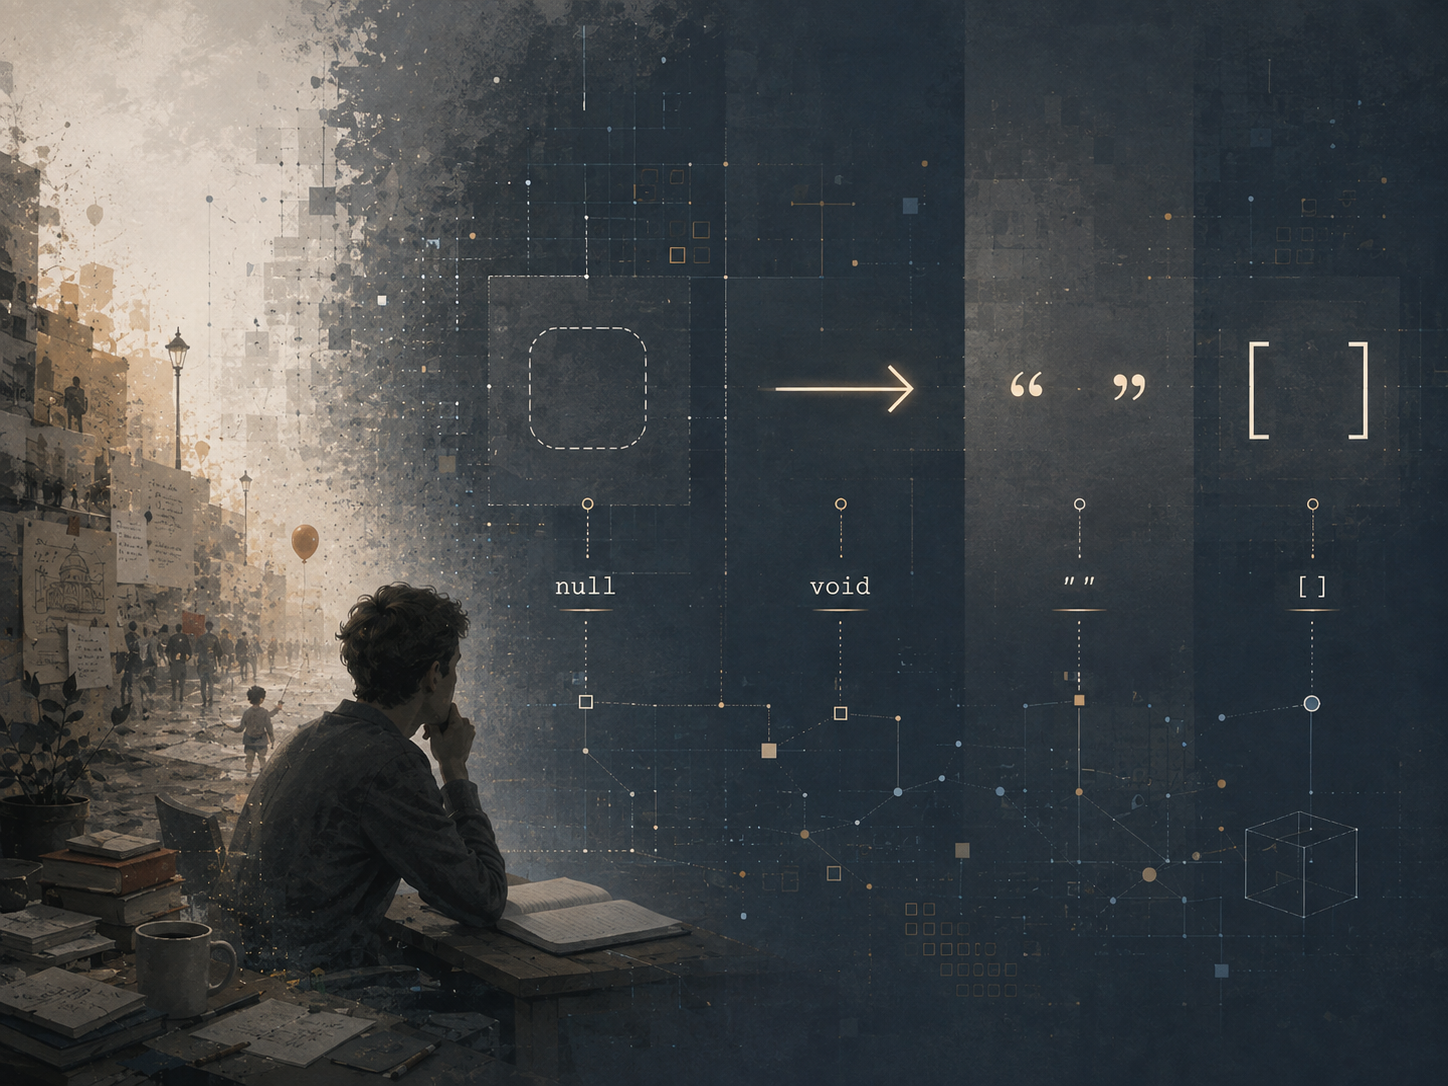
null 是对象的缺席,void 是返回值的缺席,空字符串和空数组则是确实存在、但内容为空的数据结构。人类语言可以含糊,计算机却必须区分。
三、对象:世界必须先成为“某物”
面向对象程序设计中最常见的词是“对象”。
什么是对象?
一个对象必须具有身份、属性和行为。
一个用户有姓名、邮箱、权限和登录状态;
一个订单有编号、金额、商品和支付状态;
一家公司有员工、客户、资产和业务规则。
现实中的人和事原本是流动的、复杂的,甚至充满矛盾。但进入系统之后,它们必须被定义为某种可以识别、保存和处理的东西。
这意味着,建立信息系统的第一步并不是写代码,而是回答:
这个世界究竟由什么东西组成?
这是一个非常古老的哲学问题。
柏拉图寻找理念,亚里士多德讨论实体与属性,
现代程序员则设计类、字段、接口和数据模型。
哲学家用概念描述世界,程序员用模型重建世界。
区别在于:哲学模型可以停留在思想中,程序模型必须运行。
四、身份:什么时候还是“同一个人”
现实世界中的“同一个人”,似乎不需要解释。
可是进入 IT 系统之后,身份立刻成为问题。
姓名相同,是同一个人吗?
邮箱改变了,还是原来的用户吗?
身份证号码录错一位,是新人,还是旧人的错误记录?
两个系统中的两条数据,究竟代表两个人,还是同一个人在不同数据库中的投影?
于是,IT 必须区分姓名、标识符、账号、凭证与真实身份。
用户名不是人,邮箱不是人,数据库中的一行记录也不是人。它们只是系统为了识别人而建立的代理。
但系统运行久了,人们很容易反过来相信:记录就是本人,评分就是能力,标签就是人格,画像就是一个人的全部。
这也是 IT 最深的哲学风险之一:
为了让世界进入系统,我们必须简化世界;但简化成功以后,我们又很容易把模型误认为世界本身。
地图原本只是为了寻找道路,最后却可能反过来决定什么地方值得存在。
五、状态:存在不是静止,而是变化
在信息系统里,一个对象仅仅“存在”还不够,它还必须处于某种状态。
订单是待支付、已支付、已发货,还是已取消?
用户是游客、会员、管理员,还是已冻结?
文档是草稿、审核中、已发布,还是已归档?
同一个对象,因为状态不同,可以拥有完全不同的意义。
这说明 IT 对存在的理解并不是静态的。一个东西是什么,不仅取决于它有哪些属性,也取决于它正处于什么阶段,以及它能够转变成什么。
然而,状态不能随意变化。
已取消的订单不能突然变成已发货;
已删除的账户不能在没有恢复程序的情况下继续登录;
未经审核的内容不能直接成为正式发布版本。
因此,系统必须定义合法的状态转换。
现实生活常常允许人含糊地说:“事情差不多办完了。”
计算机却必须知道:到底完成了没有?
在数据库里,含糊不是温柔,而是错误。
六、权限:存在并不等于有权使用
IT 还重新定义了一个政治哲学问题:权力。
一个对象存在于系统中,不等于所有人都可以看到它;
一个人能够看到,不等于能够修改;
能够修改,不等于能够删除;
能够操作,不等于有权授权别人操作。
于是,系统必须区分所有权、访问权、操作权和管理权。
这与现实政治中的权利、权力、权威十分相似。
很多系统事故,本质上并不是技术故障,而是权力边界设计失败:谁可以做什么,没有被定义清楚;或者本来只应拥有局部权限的人,得到了整个系统的钥匙。
从这个角度看,权限系统就是一种微型宪政。
它不假定每个人永远善良,而是预先承认:权力必须被限制,行为必须被记录,关键操作必须可以追溯。
好的系统从不依靠“大家自觉”。
它把不信任写进结构,同时又为合作保留可能。
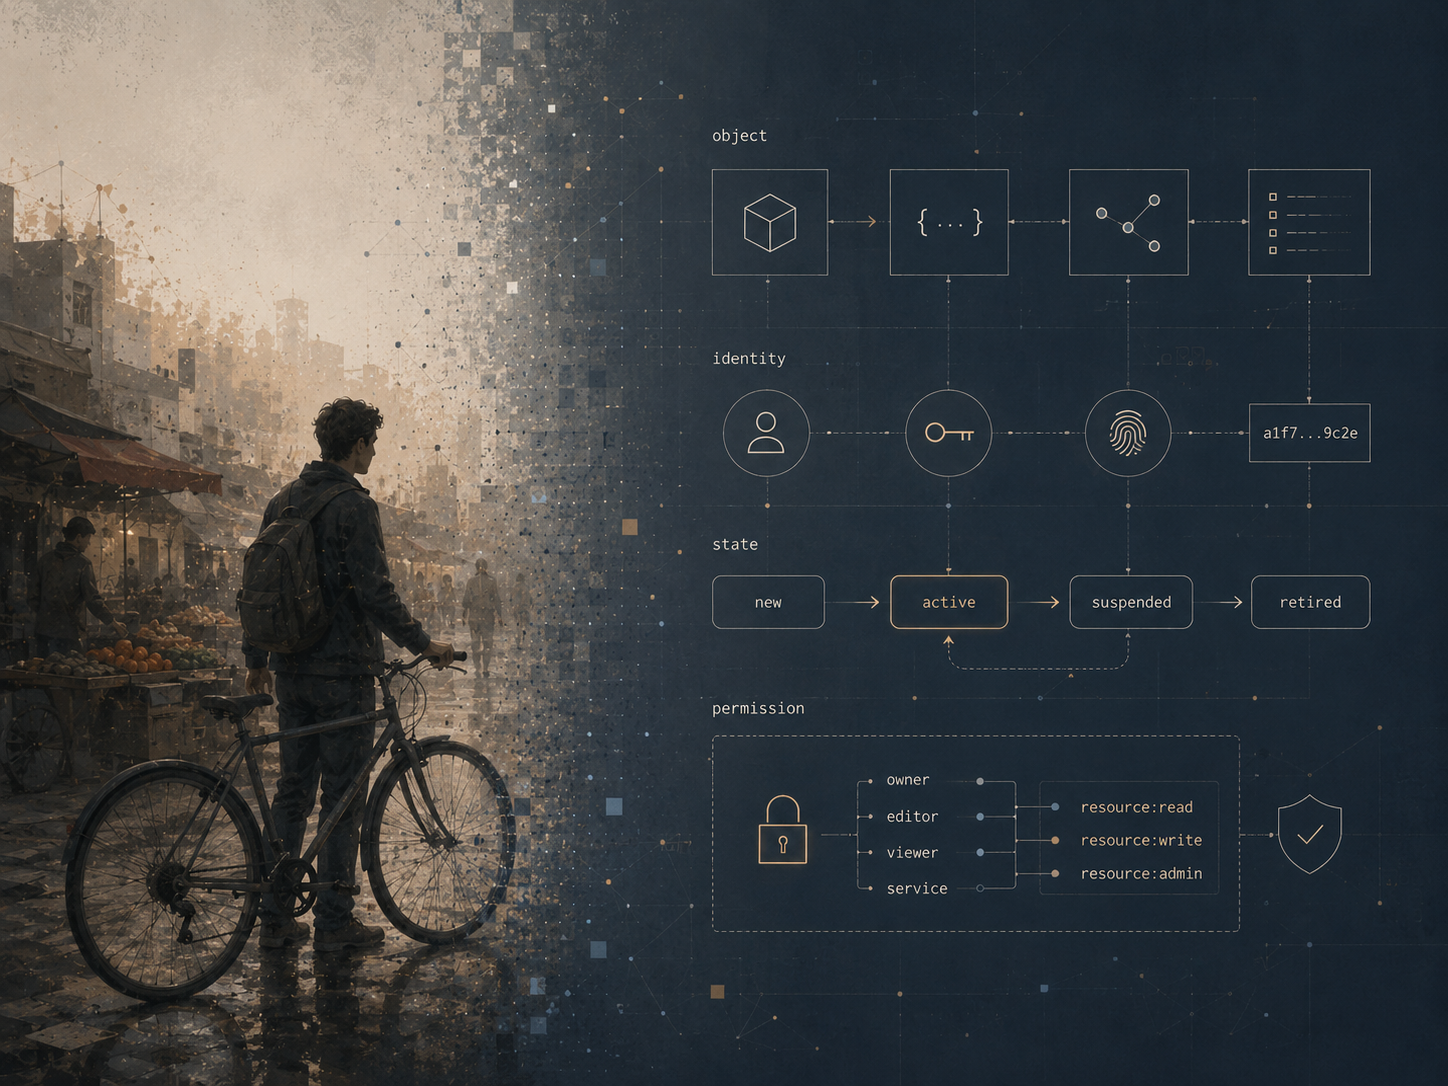
一个现实中的人或事物进入信息系统后,会被重新表达为对象、身份、状态和权限。系统能够运行,并不意味着它已经完整理解了现实。
七、IT 人何以接近哲学
当然,并不是每一个写代码的人都是哲学家,正如并不是每一个会说话的人都是思想家。
但一个真正喜欢追问的 IT 人,会很自然地走向哲学。
因为他迟早会发现,技术问题的底层往往不是技术。
数据模型设计失败,可能是因为没有想清楚事物的边界。
权限体系混乱,可能是因为没有区分权利与权力。
人工智能产生偏差,可能是因为人把带有价值判断的数据,当成了中性的事实。
系统不断增加补丁,可能是因为最初对世界的理解就是错误的。
代码只是把这种错误忠实地执行了出来。
机器不会替人解决哲学问题。机器只是迫使人把那些原本可以含糊过去的问题,明确写出来。
什么是一个人?
什么算一次完成?
什么叫相同?
什么叫拥有?
什么叫不存在?
什么可以改变,什么不可越界?
这些都是哲学问题,也是 IT 系统每天都在回答的问题。
八、代码不是世界,却暴露了我们如何理解世界
IT 最深刻的地方,不在于它制造了多少工具,而在于它迫使人类把自己理解世界的方式形式化。
在现实中,我们可以依靠经验、默契和常识生活;在系统中,一切都必须被定义。
定义不清,系统便无法运行。
定义错误,系统也许仍然能够运行,却会稳定、快速而大规模地制造错误。
因此,真正重要的从来不只是代码写得对不对,而是代码背后的世界观是否成立。
程序员写下一个对象、一条规则、一种权限、一个空值判断时,看似只是在处理技术细节,实际上却在决定:
什么可以存在,什么必须缺席;
什么能够发生,什么应当被禁止;
什么被系统看见,什么将被系统遗忘。
哲学家用语言解释世界。
IT 人则必须把一种对世界的解释,变成可以运行的结构。
也正因为如此,当一个 IT 人开始认真思考,他很难不接近哲学。
因为他逐渐明白:
世界之所以能够在 IT 中站立,不是因为机器足够强大,而是因为人先为世界建立了一套关于存在、关系、时间、身份与秩序的定义。
而所有定义的背后,都藏着一个尚未被写进代码的问题:
我们所建立的,究竟只是一个能够运行的系统,还是一个值得人生活其中的世界?